Diffusion过程
扩散(Diffusion)在热力学中指细小颗粒从高密度区域扩散至低密度区域,在统计领域,扩散则指将复杂的分布转换为一个简单的分布的过程。
Diffusion模型定义了一个概率分布转换模型,能将原始数据构成的复杂分布转换为一个简单的已知参数的先验分布:
受到物理领域的热动力学相关知识启发,Diffusion模型提出可以用马尔科夫链(Markov Chain)来构造,即定义一系列条件概率分布,将依次转换为,,…,,希望当时,。
能满足这个期望的组合选择有很多,最简洁有效的选择就是正态分布,即:
即已知时,的概率分布是一个平均值为,协方差为的正态分布。
根据重参数化技巧可得:
这一过程可以视作与标准正态分布噪声混合,扩散率系数控制融合分布和标准正态分布的混合比例。从原始数据分布到,这一过程可以视作是在重复地给原始数据分布添加噪声,直到变为一个简单固定的分布为止。
扩散率到底是什么呢?数据分布混合噪声分布时的比例为什么要设计成和呢?
假设,,那么:
公式中第二行到第三行的转换利用了一个性质:两个正态分布和相加,新分布为。
将公式3写为条件概率形式,可以得到:
由于,那么。时,。可以看出,和作为系数保证了当
时,。实际上,只要取一个足够大的值,不需要无限次迭代,得到的分布就已经很接近于标准正态分布了。
具体的取值可以预先定义。原论文使用从0.0001到0.02的线性插值作为所有的取值。
以上就是原数据分布到简单先验噪声分布的转换过程的描述。值得注意的是,当预定义时,上述整个扩散过程没有出现一个可学习的参数,就可以将任意原始复杂的分布转换为简单先验分布(标准正态分布)。
下面的示意图展示了一维数据分布中的两个样本(分别标识为蓝色和红色),经过多次加噪,最终被转换为中的两个样本的过程。
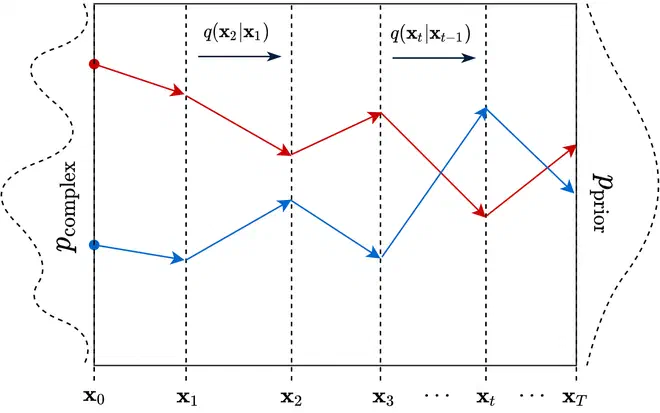
通过Diffusion模型的前向过程,复杂的分布被转换为了一个标准正态分布。
逆转Diffusion过程
和GAN类似,Diffusion模型的最终目标是从中采样一个样本,将其转换为原始数据分布中的一个样本。显然,如果逆转上一节提到的Diffusion过程,依次从中采样,Diffusion模型就可以实现从到数据分布的转换。
现在问题来了,到底是什么样的分布呢?
Feller等人在1949年证明连续扩散过程的逆转具有与正向过程相同的分布形式。即当扩散率足够小,扩散次数足够多时,离散扩散过程接近于连续扩散过程,的分布形式同一致,同样是高斯分布。
但是很难直接写出的分布参数。为此,可以用分布来近似:
其中和都是要学习的函数,接受作为参数。
这样,连续迭代多次后,可以得到近似的真实数据分布为:
其中为的联合概率分布。借助条件概率公式:
在有了和后,就被确认了下来。就可以完成逆转Diffusion过程了。如下图所示: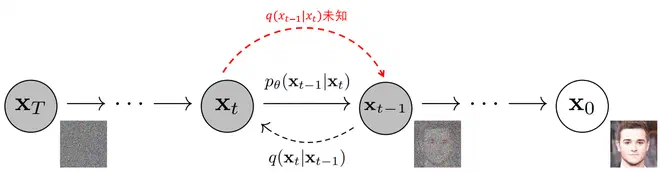 首先从中采样得到,然后在以为均值,为方差的正态分布中采样得到。依次重复这个过程,直到得到最终结果。由于未知,所以在逆转Diffusion过程中,用学习到的代替它。
以二维平面上的一个数据集为例,原数据集中的二维数据构成了类似于字母e的一个图案,在Diffusion前向过程中,经过两次迭代,原始数据分布就被转换为了第一行第三列这样丧失了所有结构信息的分布,接近于高斯噪声分布。而逆转Diffusion过程则在时刻开始,先从高斯噪声中采样,然后依次得到和时刻的数据分布。重建得到的分布很接近于原始数据分布,得到了一个非常不错的生成模型。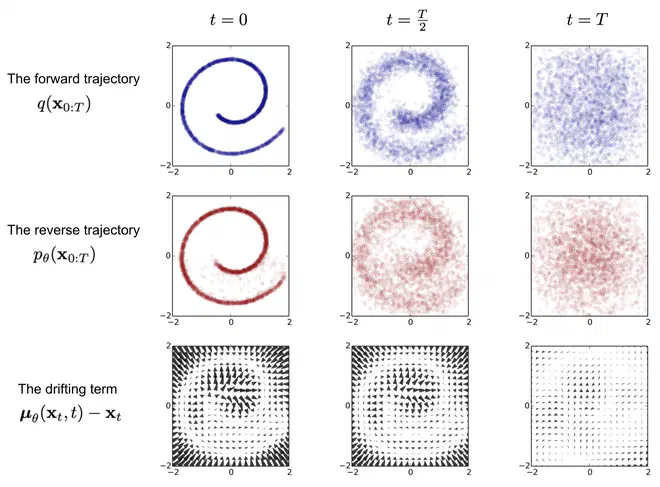
上图中还有一行值得注意,即第三行的漂移项。从到,实际是一个采样过程。逆扩散过程中,第时刻的一个数据点,对应于第时刻的一个高斯分布。这听起来有些奇怪,期望逆Diffusion过程能将非结构化的噪声分布转化为结构化的数据分布,中间每一个步骤应当更”结构化“才对,怎么时刻的一个数据点变成了时刻的一个高斯分布了呢?点到分布,似乎更”乱“,更”非结构化“了。实际上,对应分布的方差,的取值很接近于,即方差很小,而平均值是被网络预测(可以视作一个去噪过程)得到。只要预测的准,能准确的去除的噪声,就消除了分布中的“非结构化”信息。如第三列所示,在噪声比较大的地方(即远离原数据分布的点),值也大;而噪声小的地方,接近于0。
总结地说,Diffusion过程可以被视作在逐渐加噪声,而逆Diffusion过程则是在逐渐去噪声。学习的网络需要建模估计输入图片中的噪声。
训练目标
现在只剩下最后一个问题,究竟怎么优化得到理想的和?类似于其它生成模型,可以最小化在真实数据期望下,模型预测分布的负对数似然,即最小化预测和的交叉熵:
事实上没法写出的表达式,直接计算上面的交叉熵难度很大。目前已知的仅有公式6,7以及和的表达式。为此,可以做一些数学推导,将公式8中的转换为已知的东西:
其中,等式变不等式那一步利用了Jensen不等式。根据公式9,为了最小化,我们可以转而去最小化其上界。
上式中蓝色部分直接的变换实际上利用了贝叶斯公式:
注意由马尔科夫链的性质,有。
再重新看公式10的最后一行,可以看出实际上由一个熵(),以及多个KL散度()构成。其中中和一个是先验分布,一个是数据分布,都是固定的,故是一个常数,最小化时可以忽略。可以只去研究和。
分布和分布之间的KL散度
根据公式5,分布是一个高斯分布,其平均值和方差由Diffusion模型网络预测产生。
而分布可以根据贝叶斯定律,即公式11继续推下去得到:
继续推导下去,可以发现同样是一个高斯分布。假设:
那么,由公式12,公式13中的两个新变量:
因此,最小化这个KL损失实际上目标就是拉近下面这两个高斯分布的距离:
多元正态分布之间的KL散度可以直接根据分布参数计算出来。
上式中是一个不依赖于的常数。为了模型简单,可以令,其中可以设置为或,论文说这两个选择效果差不多。实际上,当时,公式15中的两个分布的方差就一样了。这一选择是为了简化计算,并不是唯一的。
从公式16来看,只需要定义一个网络,使用L2损失约束其预测值同一致即可。具体来说,可以定义一个接受和作为参数的网络,从原数据分布中采样一个数据,通过公式3计算得到,然后利用公式14计算得到,将和送入网络得到。使用L2损失约束两个样本一致,并优化网络。
但DDPM并没有停止于此,继续分析化简公式16。的输入有,而以作为输入。借助公式3,可以得到。将其代入,有:
根据公式16和公式17,在给定的情况下,需要预测出。为了降低学习的难度,可以直接定义:
这样,公式16可以继续简化:
公式19表示在优化时,采样和,后计算,然后联合时间,送入,得到预测值,约束其与一致。
计算
已知,而。所以实际上是一个多元高斯分布的负对数似然的期望,即其熵。多元高斯分布的熵仅与其协方差有关,即仅与有关,是一个常数。
然而,论文DDPM指出,一般而言,的分布实际上是离散的,而不是连续的。比如图片数据,像素值取值必须是整数,归一化到后,依然是离散的点。Diffusion前向的第一步实际上是为离散数据添加噪声。那么,逆Diffusion的最后一步,即从到,也不能被简单地看作从中采样,而是在从采样的基础上再加上离散化操作。也不再是一个常数,而是一个与相关的积分,其具体表达式可以参考DDPM的Sec3.3。在忽略和边缘效应后,的取值可以被的密度函数与离散时的分块大小(bin width)相乘所拟合。
另外值得一提的是,逆Diffusion的最后一步,DDPM直接取作为。
简化训练目标
上文已经分别描述了的计算过程,最终可以按照公式10,最小化来优化网络。论文DDPM发现,去除中的加权系数,得到简化的训练目标如下:
公式中从中均匀采样。时对应于的一个近似,时对应于去除了加权系数的公式19。
相对于直接计算,实现起来更加简单,较小时的权重被减少,较大时的权重被增加。这样网络能更专注于较大,图片中噪声更多时,更难更复杂的噪声预测任务。
训练采样流程
可以将上文描述的Diffusion模型的训练采样过程分别总结如下:
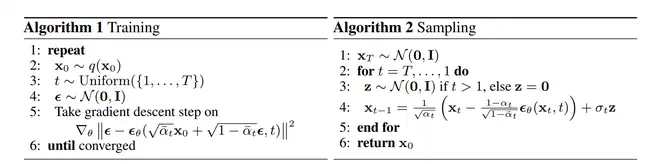
训练时,分别从、、中采样得到,和,利用公式3计算得到,将和送入网络,预测得到一个噪声。最小化预测噪声和真实采样的之间的距离。重复这一过程直到网络收敛。
Diffusion模型的逆转采样每个时刻主要包含以下三步:
- 将和送入网络,预测得到噪声
- 利用估计的噪声和,计算
- 如果,需要从中采样得到,利用重参数化技巧,可以将采样过程转换为首先采样,然后计算。如果,直接令
总结
Diffusion模型的每一步推导都有严密的数学基础,调整其细节时,必须仔细思考背后的数学基础。如果它火起来,成为生成模型的主流,简直是不给我这种调参侠活路!
进一步阅读
写本篇博客时,我主要参考了下述论文和博客文章。
相关论文:
Sohl-Dickstein, J., Weiss, E.A., Maheswaranathan, N., & Ganguli, S. (2015). Deep Unsupervised Learning using Nonequilibrium Thermodynamics. ArXiv, abs/1503.03585.
Ho, J., Jain, A., & Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. ArXiv, abs/2006.11239.
网页链接
- What are Diffusion Models? | Lil’Log (lilianweng.github.io)
- diffusion_models/Diffusion_models.ipynb at main · InFoCusp/diffusion_models (github.com)
- Ayan Das · An introduction to Diffusion Probabilistic Models